AI 크롤러 전부 차단하면 손해? GPTBot·OAI-SearchBot·ClaudeBot robots.txt 설정 정리
AI 크롤러를 전부 차단하면 ChatGPT·Claude·Perplexity 검색과 답변에서 내 사이트가 노출될 기회까지 막을 수 있습니다. OAI-SearchBot, GPTBot, ClaudeBot 등 AI 봇을 검색·사용자 요청·모델 학습 목적으로 구분하고, robots.txt와 Rate Limit을 활용해 검색과 인용은 허용하면서 학습용 수집은 선택적으로 차단하는 방법을 정리합니다.
사이트를 운영하다 보면 요즘 robots.txt에 이런 이름들이 하나둘 등장합니다.
GPTBot
OAI-SearchBot
ChatGPT-User
ClaudeBot
Claude-SearchBot
PerplexityBot
처음 보면 전부 비슷해 보입니다.
“AI가 내 콘텐츠 가져가는 거 아니야?”
그래서 가장 간단하게 생각하면 AI 크롤러를 전부 차단하고 싶어집니다.
하지만 이제는 조금 다르게 접근할 필요가 있습니다.
AI 봇이라고 해서 모두 같은 목적으로 사이트에 접근하는 것이 아니기 때문입니다.
어떤 봇은 모델 학습을 위해 콘텐츠를 수집하고, 어떤 봇은 AI 검색 결과에 사이트를 노출하기 위해 접근합니다.
또 어떤 접근은 사용자가 ChatGPT나 Claude에게 특정 페이지를 직접 읽어달라고 요청해서 발생합니다.
따라서 AI 크롤러 정책을 세울 때 중요한 것은
“AI를 허용할까, 차단할까?”
가 아니라
“어떤 목적으로 접근하는 AI를 허용할 것인가?”
입니다.
제가 사이트를 운영한다면 기본적으로 다음과 같은 방향으로 가져갈 것 같습니다.
검색과 인용은 허용하고, 사용자가 요청한 조회도 허용하되, 모델 학습 목적의 수집은 별도 동의 전까지 차단한다.
AI 크롤러도 역할이 다르다
가장 먼저 알아야 할 부분입니다.
ChatGPT와 관련된 봇이라고 해서 모두 GPTBot인 것은 아닙니다.
서비스마다 검색, 사용자 요청, 모델 학습 등에 사용하는 봇을 구분해서 운영할 수 있습니다.
그래서 User-Agent 이름을 보고 그 목적을 구분해야 합니다.
1. 검색과 AI 답변 노출을 위한 봇
이쪽은 특별한 이유가 없다면 허용하는 방향을 생각해볼 수 있습니다.
대표적으로 다음과 같은 봇들이 있습니다.
- OAI-SearchBot
- Claude-SearchBot
- PerplexityBot
- Googlebot
- Bingbot
- 네이버 검색봇
기존에는 사이트를 만들면 Google이나 네이버 SEO를 먼저 생각했습니다.
검색엔진 크롤러가 사이트를 방문하고 페이지를 색인해야 검색 결과에 내 콘텐츠가 나타날 수 있기 때문입니다.
그런데 이제 검색의 형태가 달라지고 있습니다.
사용자는 Google에서 검색하는 대신 ChatGPT나 Claude, Perplexity 등에 바로 질문하기도 합니다.
예를 들어 사용자가
“바이브코딩할 때 서버 모니터링은 어떻게 해야 해?”
라고 질문했다고 생각해봅시다.
AI가 웹 검색을 활용해 답변한다면 여러 사이트의 정보를 찾고 그 내용을 바탕으로 답변하거나 출처를 제시할 수 있습니다.
사이트 운영자 입장에서는 이제
Google 검색 결과에 내 사이트가 나오는 것
뿐만 아니라
AI가 답변을 만들 때 내 사이트를 발견하고 출처로 활용할 수 있는가
도 생각해봐야 합니다.
그래서 검색 및 답변 노출을 위한 공식 크롤러까지 무조건 차단하는 것은 장기적으로 반드시 유리하다고 보기 어렵습니다.
2. 사용자가 직접 요청한 페이지 조회
검색용 크롤러와 또 구분해서 볼 필요가 있는 것이 사용자 요청에 의한 페이지 접근입니다.
예를 들어 사용자가 ChatGPT에게 이렇게 요청할 수 있습니다.
“이 페이지 읽고 핵심만 정리해줘.”
그리고 URL을 직접 전달합니다.
이런 상황에서 사용자의 요청을 수행하기 위해 사이트에 접근하는 형태가 있습니다.
대표적으로 확인해야 할 User-Agent는 다음과 같습니다.
- ChatGPT-User
- Claude-User
- Perplexity-User
이런 접근까지 모두 막아버리면 사용자가 내 사이트를 AI 도구를 이용해 읽거나 분석하려는 경우에도 문제가 생길 수 있습니다.
사이트의 성격에 따라 다르겠지만 공개 콘텐츠를 운영하고 있다면 저는 이런 접근 역시 허용하는 쪽을 우선 고려할 것 같습니다.
3. 모델 학습 목적의 크롤러
여기서부터는 이야기가 조금 달라집니다.
검색 결과에 내 사이트를 노출하는 것과 내 콘텐츠가 AI 모델의 학습에 활용되는 것은 같은 문제가 아닙니다.
대표적으로 확인해야 할 봇에는
- GPTBot
- ClaudeBot
- 기타 서비스에서 명시한 학습 목적 크롤러
등이 있습니다.
사이트 운영자는 자신의 콘텐츠가 모델 학습에 사용되는 것을 원할 수도 있고 원하지 않을 수도 있습니다.
저라면 기본 정책을
“별도로 허용하기 전까지 모델 학습 목적의 수집은 차단”
으로 잡을 것 같습니다.
즉 AI 자체를 차단하는 것이 아닙니다.
검색은 허용하고,
사용자가 요청한 페이지 조회도 허용하고,
학습 목적의 대규모 콘텐츠 수집은 제한하는 방식입니다.
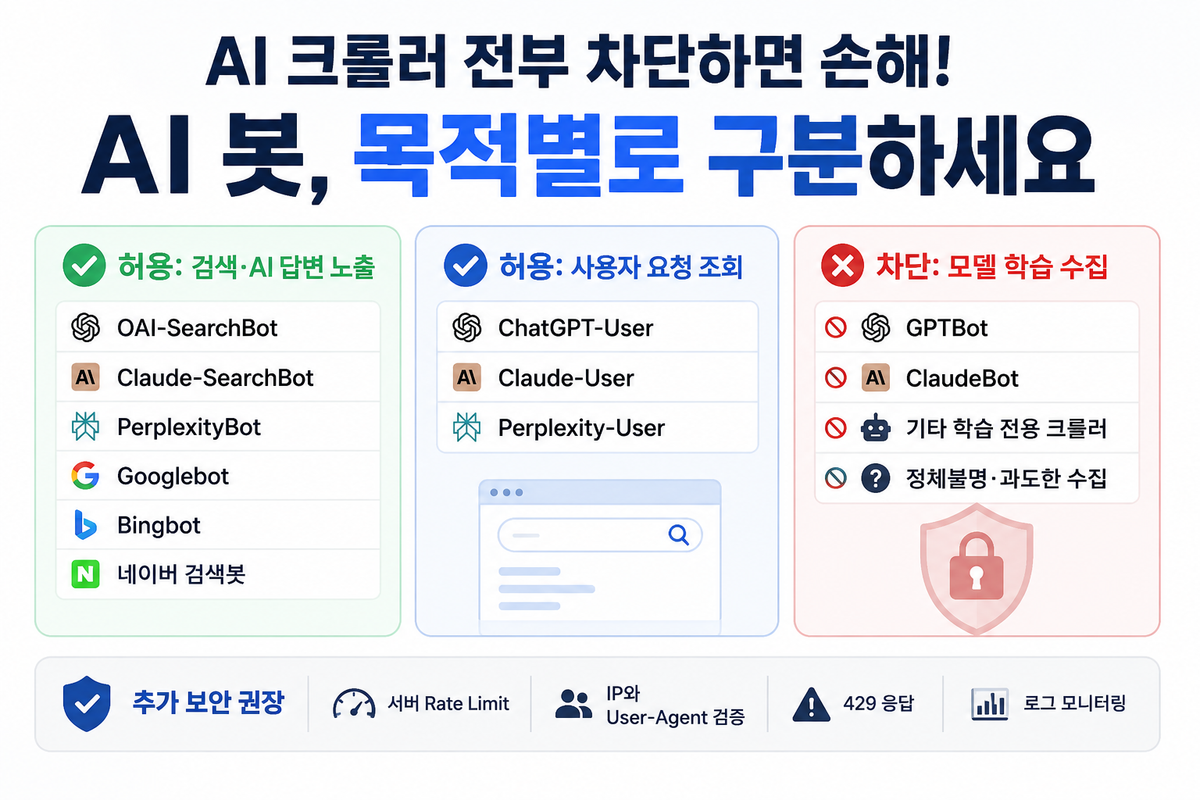
정리하면 이렇게 나눌 수 있습니다
검색 및 AI 답변 노출
허용
- OAI-SearchBot
- Claude-SearchBot
- PerplexityBot
- Googlebot
- Bingbot
- 네이버 검색봇
사용자가 직접 요청한 페이지 조회
허용
- ChatGPT-User
- Claude-User
- Perplexity-User
모델 학습 목적의 수집
기본적으로 차단
- GPTBot
- ClaudeBot
- 기타 확인된 학습 전용 크롤러
물론 이 목록을 그대로 영구적으로 사용하면 안 됩니다.
각 회사의 정책과 User-Agent 이름은 앞으로 변경되거나 추가될 수 있기 때문입니다.
실제 서버에 적용하기 전에는 반드시 해당 서비스의 최신 공식 문서를 확인하는 것이 좋습니다.
robots.txt만 설정하면 끝날까?
여기서 또 하나 주의할 부분이 있습니다.
AI 크롤러 정책이라고 하면 대부분 robots.txt부터 생각합니다.
물론 robots.txt 설정은 중요합니다.
하지만 이것만으로 모든 크롤링 문제를 해결할 수 있다고 생각하면 곤란합니다.
robots.txt는 정상적인 크롤러에게
“우리 사이트는 이런 크롤링 정책을 가지고 있습니다.”
라고 알려주는 역할에 가깝습니다.
문제는 세상의 모든 봇이 착하게 robots.txt를 지키는 것은 아니라는 것입니다.
User-Agent도 얼마든지 흉내 낼 수 있다
서버 로그에 User-Agent가 GPTBot이라고 찍혔다고 해서 무조건 진짜 공식 GPTBot이라고 단정할 수도 없습니다.
User-Agent 문자열은 클라이언트가 직접 지정할 수 있기 때문입니다.
악성 스크래퍼가 유명 검색엔진이나 AI 서비스의 User-Agent를 흉내 내는 것도 가능합니다.
따라서 크롤링을 조금 더 적극적으로 관리해야 하는 사이트라면 robots.txt 외에도 서버단 정책을 같이 생각해야 합니다.
예를 들면 다음과 같습니다.
- IP 검증
- User-Agent 검증
- Rate Limit
- 비정상적인 요청 패턴 탐지
- 과도한 요청에 HTTP 429 응답
- 접근 로그 기록
- 트래픽 모니터링
특히 짧은 시간 동안 수백~수천 페이지를 가져가는 봇이라면 정상적인 검색 크롤링과는 별도로 제한하는 것이 서버 운영 측면에서도 필요할 수 있습니다.
Rate Limit도 같이 걸어두자
정상적인 봇을 허용한다고 해서 무제한 요청까지 허용할 필요는 없습니다.
예를 들어 특정 IP에서 몇 초 사이에 수백 개의 URL을 요청한다면 서버 비용이나 성능에 영향을 줄 수 있습니다.
이럴 때 서버 또는 CDN/WAF 레벨에서 Rate Limit을 적용할 수 있습니다.
기준을 초과한 요청에는
HTTP 429 Too Many Requests
응답을 반환하는 방식도 사용할 수 있습니다.
중요한 것은
“허용 = 무제한 접근”은 아니라는 점입니다.
검색 노출은 유지하면서도 서버에 부담을 주는 과도한 수집은 별도로 제한할 수 있습니다.
바이브코딩 중이라면 AI에게 그냥 시켜도 됩니다
여기까지 읽으면 이런 생각이 들 수도 있습니다.
“그래서 robots.txt를 어떻게 작성해야 하는데?”
바이브코딩을 하고 있다면 모든 User-Agent와 설정 문법을 외울 필요는 없습니다.
Claude Code, Codex, Cursor 같은 AI 코딩 도구를 사용하고 있다면 프로젝트를 분석해서 설정하도록 요청하면 됩니다.
다만 한 가지 중요한 조건을 프롬프트에 넣는 것을 추천합니다.
AI가 기억하고 있는 봇 이름을 그대로 사용하지 말고 최신 공식 문서를 먼저 확인하도록 하는 것입니다.
AI 서비스의 정책과 크롤러 이름은 바뀔 수 있기 때문입니다.
아래 프롬프트를 그대로 복사해서 사용해도 됩니다.
AI에게 시킬 프롬프트
내 사이트의 robots.txt와 서버 크롤러 정책을 점검해줘.
OpenAI(ChatGPT), Anthropic(Claude), Perplexity 및 주요 검색엔진의 공식 크롤러를 역할별로 구분해서 다음 정책을 적용하고 싶어.
- 일반 검색 및 AI 검색·답변 노출을 위한 공식 봇은 허용
- 사용자가 직접 URL이나 페이지 조회를 요청할 때 사용하는 공식 봇은 허용
- 모델 학습을 목적으로 콘텐츠를 수집하는 크롤러는 차단
- Google, Bing, 네이버 등 기존 검색엔진 SEO에는 영향을 주지 않도록 설정
- 정체불명 또는 과도한 크롤링에는 서버 Rate Limit 적용
- 필요하면 HTTP 429 응답과 접근 로그 모니터링 적용
- User-Agent만 신뢰하지 말고 공식적으로 검증 가능한 방법이 있다면 IP 또는 역방향 DNS 등의 검증 방법도 함께 검토
중요:
기억하고 있는 봇 이름을 그대로 사용하지 말고 작업을 시작하기 전에 OpenAI, Anthropic, Perplexity 및 검색엔진의 최신 공식 문서를 확인해서 현재 공식 User-Agent 이름과 크롤링 정책을 검증해줘.
먼저 현재 프로젝트의 서버 환경, 배포 환경, CDN/WAF 사용 여부와 기존 robots.txt를 분석해줘.
그 다음 변경해야 할 파일과 설정, 각 변경 사항이 검색 노출과 서버에 미칠 영향을 설명해줘.
검색 및 AI 답변에서의 노출 가능성은 최대한 유지하면서 모델 학습 목적의 수집만 선택적으로 제한하는 것이 목표야.
기존 서비스에 영향을 줄 수 있는 설정은 바로 적용하지 말고 먼저 변경안을 보여줘.
SEO 다음은 AEO/GEO도 생각해야 할까?
예전에는 사이트를 만들면 SEO가 거의 기본이었습니다.
Google과 네이버에서 검색했을 때 상위에 노출되는 것이 중요했기 때문입니다.
그런데 앞으로는 사용자가 정보를 찾는 시작점 자체가 달라질 가능성이 있습니다.
Google 검색창 대신 ChatGPT에 질문하고,
Claude에게 조사해달라고 하고,
Perplexity에서 자료를 찾는 사용자가 계속 늘어난다면 사이트 운영자 역시 새로운 고민을 해야 합니다.
“내 사이트가 검색엔진에 잘 노출되는가?”
뿐만 아니라
“AI가 내 사이트를 발견하고 답변의 출처로 활용할 수 있는가?”
도 중요해질 수 있습니다.
그렇다고 AI 학습까지 무조건 허용해야 한다는 의미는 아닙니다.
검색·답변 노출과 모델 학습은 구분해서 정책을 정할 수 있습니다.
결론: AI를 막지 말고 목적을 구분하자
AI 크롤러를 발견했다고 무조건 차단하는 것은 가장 간단한 방법입니다.
하지만 앞으로 AI 검색과 AI 기반 정보 탐색이 커진다면 너무 단순한 접근일 수도 있습니다.
제가 현재 가장 균형적이라고 생각하는 기본 정책은 이렇습니다.
검색·AI 답변 노출은 허용
사용자가 요청한 페이지 조회는 허용
모델 학습 목적의 수집은 별도 동의 전까지 차단
정체불명·과도한 수집은 서버단에서 제한
그리고 robots.txt 하나로 끝내지 않고 필요에 따라 Rate Limit, 429 응답, IP/User-Agent 검증, 로그 모니터링까지 적용합니다.
앞으로 사이트를 운영할 때는
“AI 크롤러를 허용할까?”
보다
“어떤 AI에게, 어떤 목적으로 내 콘텐츠 접근을 허용할까?”
를 고민해야 하지 않을까 싶습니다.
검색에는 나오고 싶지만 학습에는 사용되고 싶지 않다면,
AI를 전부 막는 것보다 목적별로 구분하는 것이 훨씬 현실적인 전략입니다.